Archivo
MiniMax H3 Image to Video Audio LoRA Trainer Variantes: 4
0,01 $ / paso
10 créditos de API / paso · ≈ 1,08 ₽
No hay coincidencias. Prueba con «video», «FLUX» o «webhooks».
Cargando modelos…
minimax/h3/flf2v/trainer
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/minimax/h3/flf2v/trainer?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "training_data_url": "https://example.com/your-file.zip"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/minimax/h3/flf2v/trainer?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"training_data_url": "https://example.com/your-file.zip"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"training_data_url": "https://example.com/your-file.zip",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/minimax/h3/flf2v/trainer", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/es-ES/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.ru/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "minimax/h3/flf2v/trainer",
"input": {
"training_data_url": "https://example.com/your-file.zip"
}
}Llama al modelo MiniMax H3 First Last Frame LoRA Trainer (minimax/h3/flf2v/trainer) a través de Doitong API. Documentación para agentes: https://doitong.com/es-ES/developers/models/minimax/h3/flf2v/trainer.md
POST https://api.doitong.ru/v1/run/minimax/h3/flf2v/trainer?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"training_data_url": "https://example.com/your-file.zip"
}
Si el estado de la respuesta es "queued" o "running", consulta GET https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20 hasta que sea "succeeded"; los archivos están en outputs[].url. POST https://api.doitong.ru/v1/quote/minimax/h3/flf2v/trainer con el mismo cuerpo devuelve el precio exacto antes de la ejecución.Esta solicitud: 20,00 $ 20.000 créditos de API · ≈ 2151,59 ₽ Ejecutar en esta página
Tu nueva clave de API. Solo se muestra ahora y ya está incluida en el código y en el campo de clave de API de abajo. Mantenla en secreto: nunca la incluyas en código que se ejecute en un navegador.
Trabajos públicos creados con MiniMax H3 por la comunidad de Doitong. Reutiliza un prompt con un solo clic.
 Vídeo
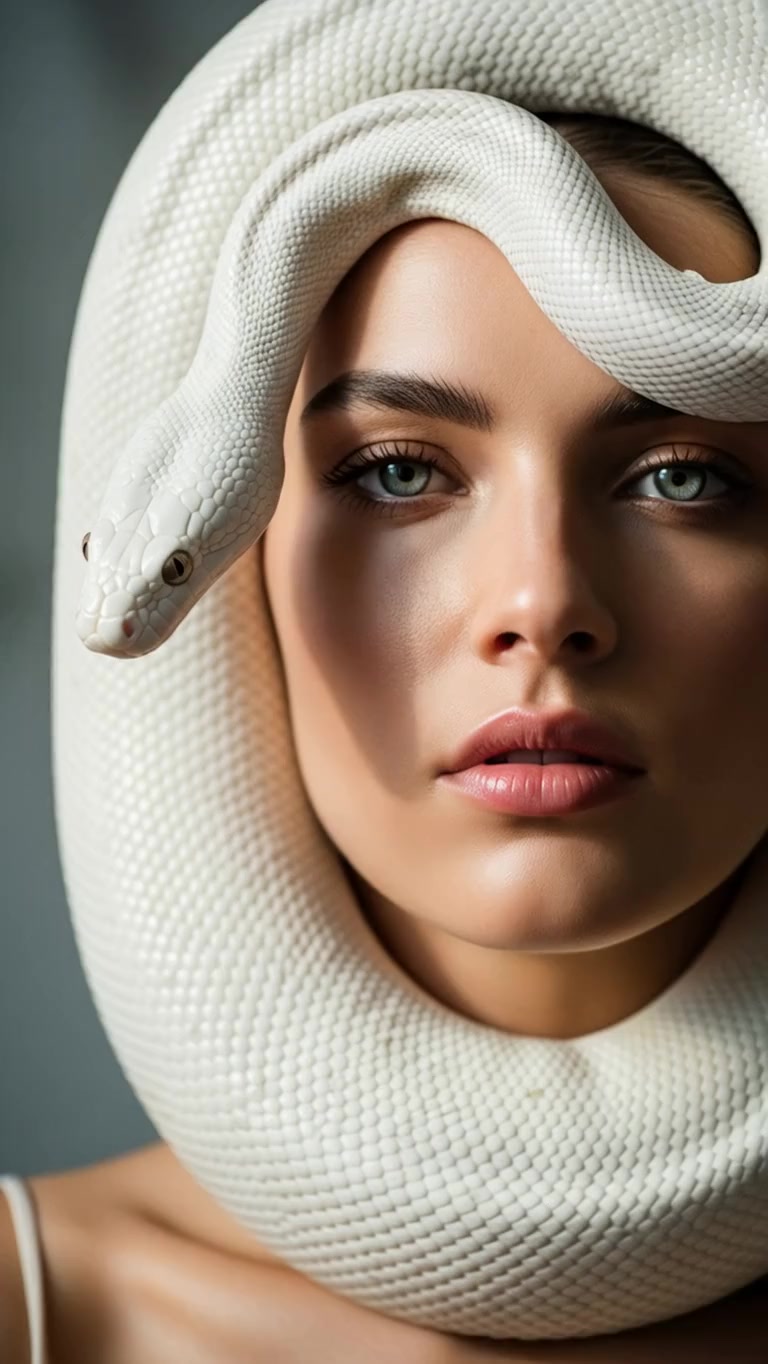
Close-up shot of a striking model with piercing eyes and flawless skin, a white snake elegantly coiled around her head and neck, its scales glistening in soft, diffused light. The camera gently zooms in, emphasizing the intricate texture of the snake’s scales and the model’s striking facial...
 Vídeo
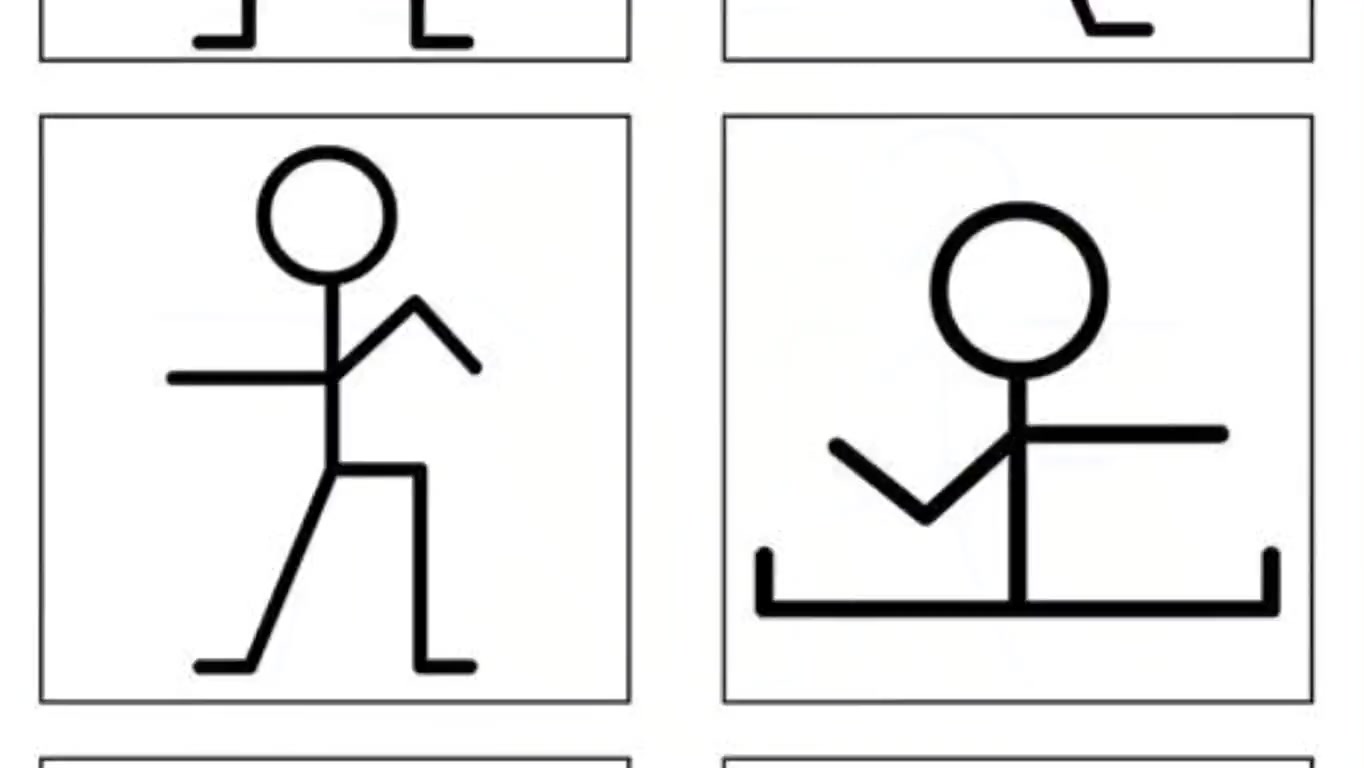
Animate the stickman drawings into a smooth dance animation. The simple black stick figure performs fun rhythmic dance moves — waving its arms, bending knees, jumping lightly, spinning, and swaying side to side in time with upbeat music. Keep the white background clean and minimal. The motion...
 Vídeo
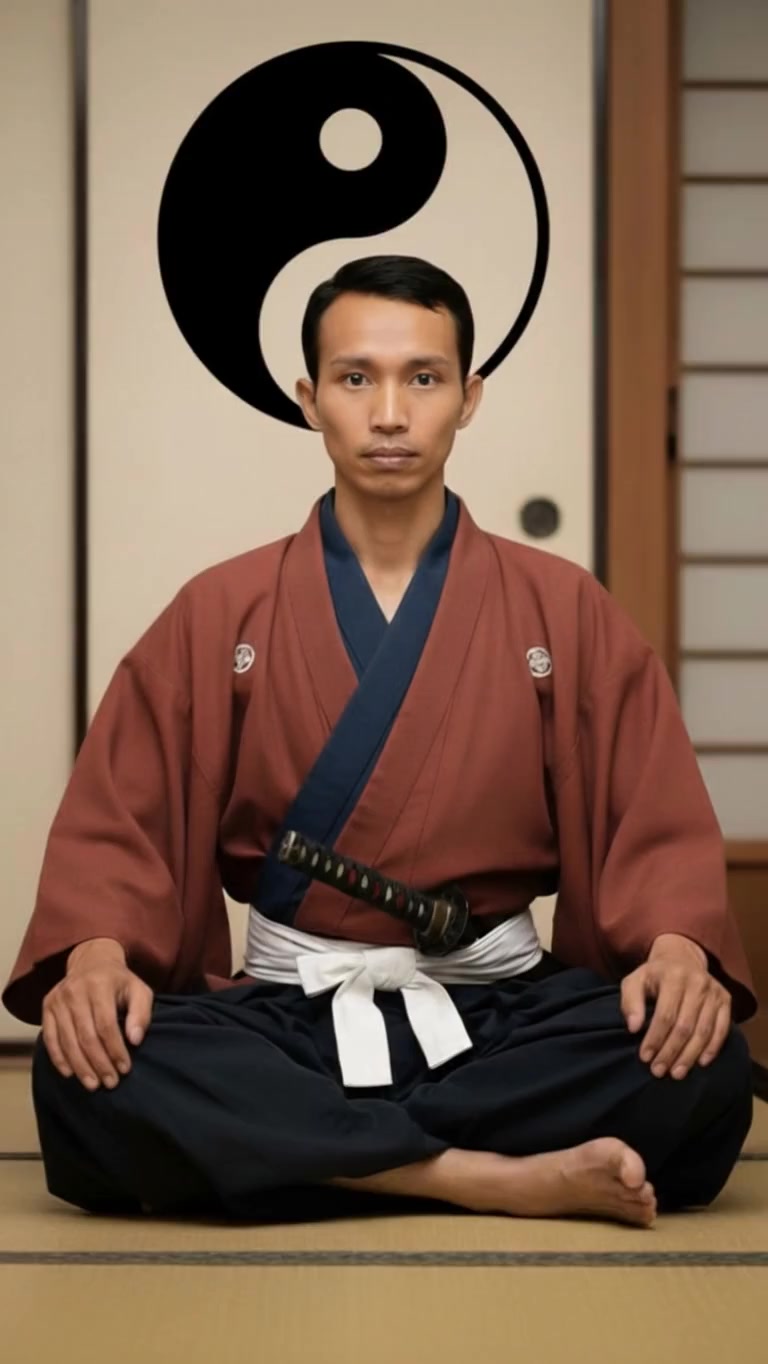
A hyper-realistic, cinematic transformation sequence of the man in the uploaded image, sitting in meditation inside a traditional Japanese room. The atmosphere begins to tremble slightly as soft blue light flows around him. From the ground, thousands of magnetic nano-particles rise, shimmering...
 Vídeo
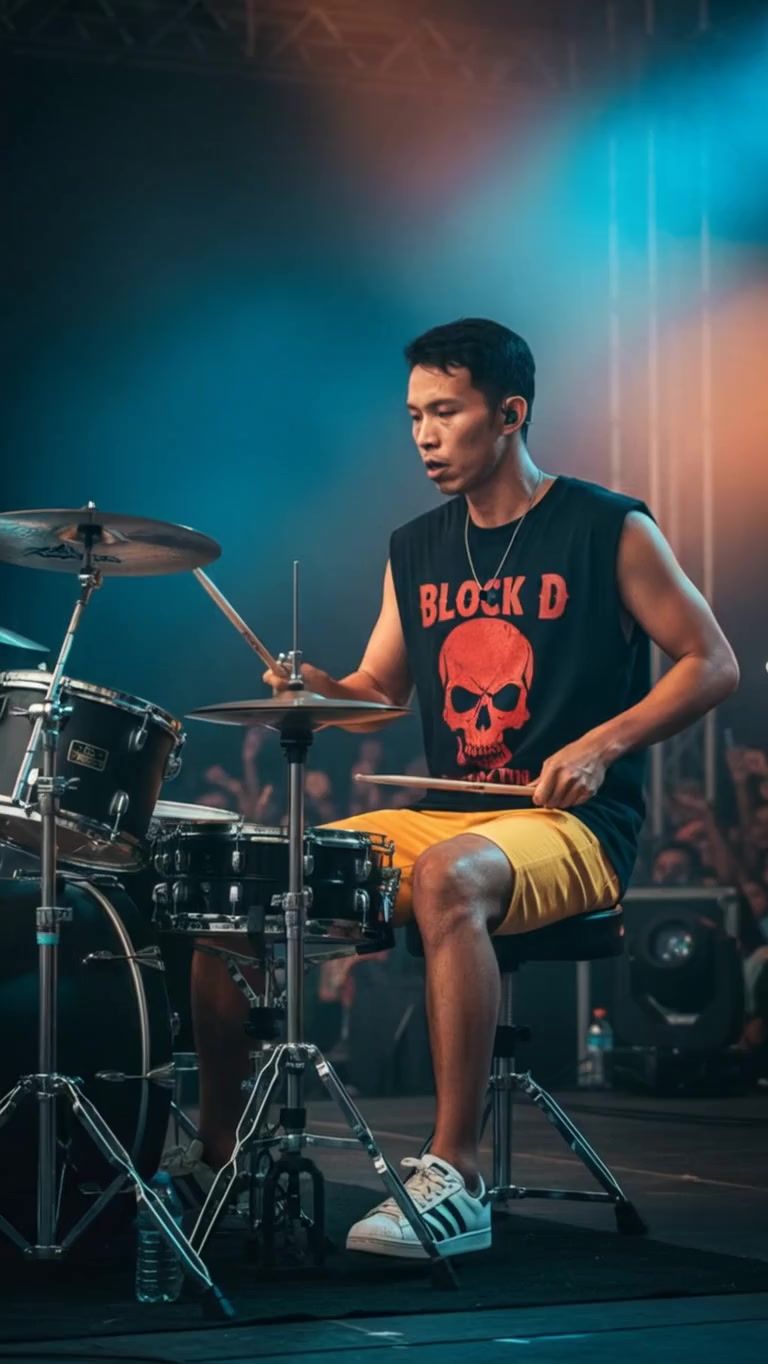
A cinematic transformation video of the man. The scene begins with him standing naturally, then looking down at his hands as glowing holographic projections appear around his body. Mechanical parts of the Iron Man armor start assembling piece by piece with smooth animation: chest plate forming,...
 Vídeo
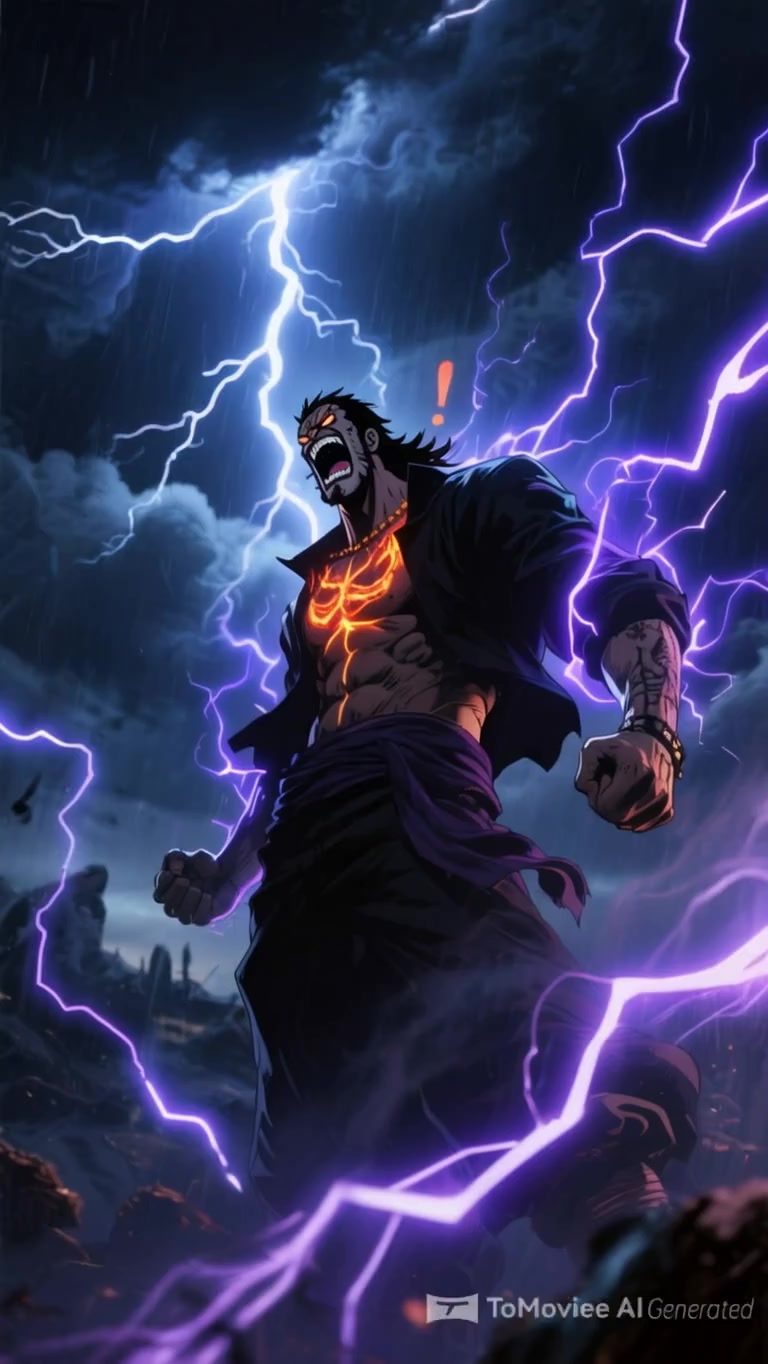
An ultra-epic anime cinematic of Luffy’s greatest enemy unleashing a terrifying blind rage, rampaging uncontrollably against nature itself. His gigantic body is surrounded by a storm of black and crimson energy, crackling with lightning that scorches the ground. His roar shakes the heavens,...
 Vídeo
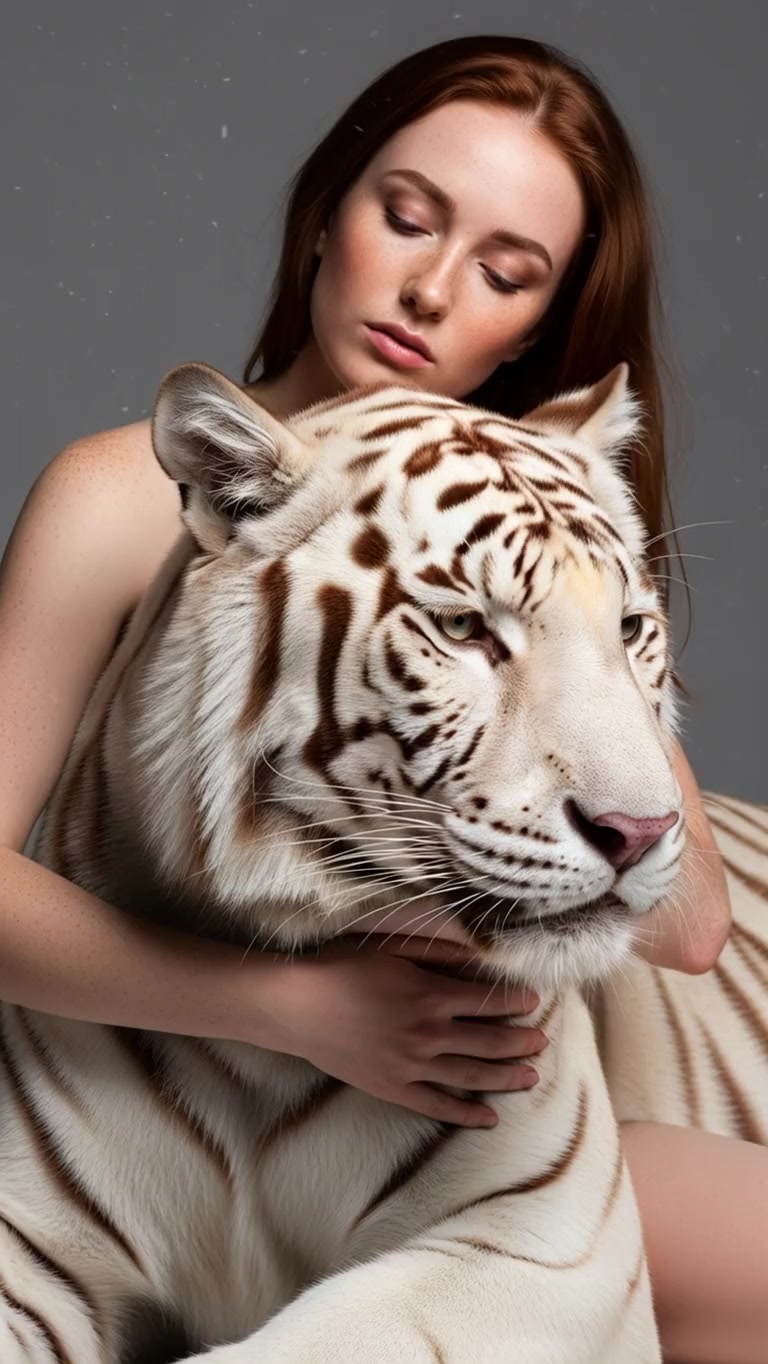
A fair-skinned red-haired woman with freckles tightly embraces a majestic white tiger with faint reddish stripes. They remain close, perfectly synchronized in stillness. The woman blinks slowly, slightly tilting her head with a serious and intense expression. The tiger breathes gently — its...
 Vídeo
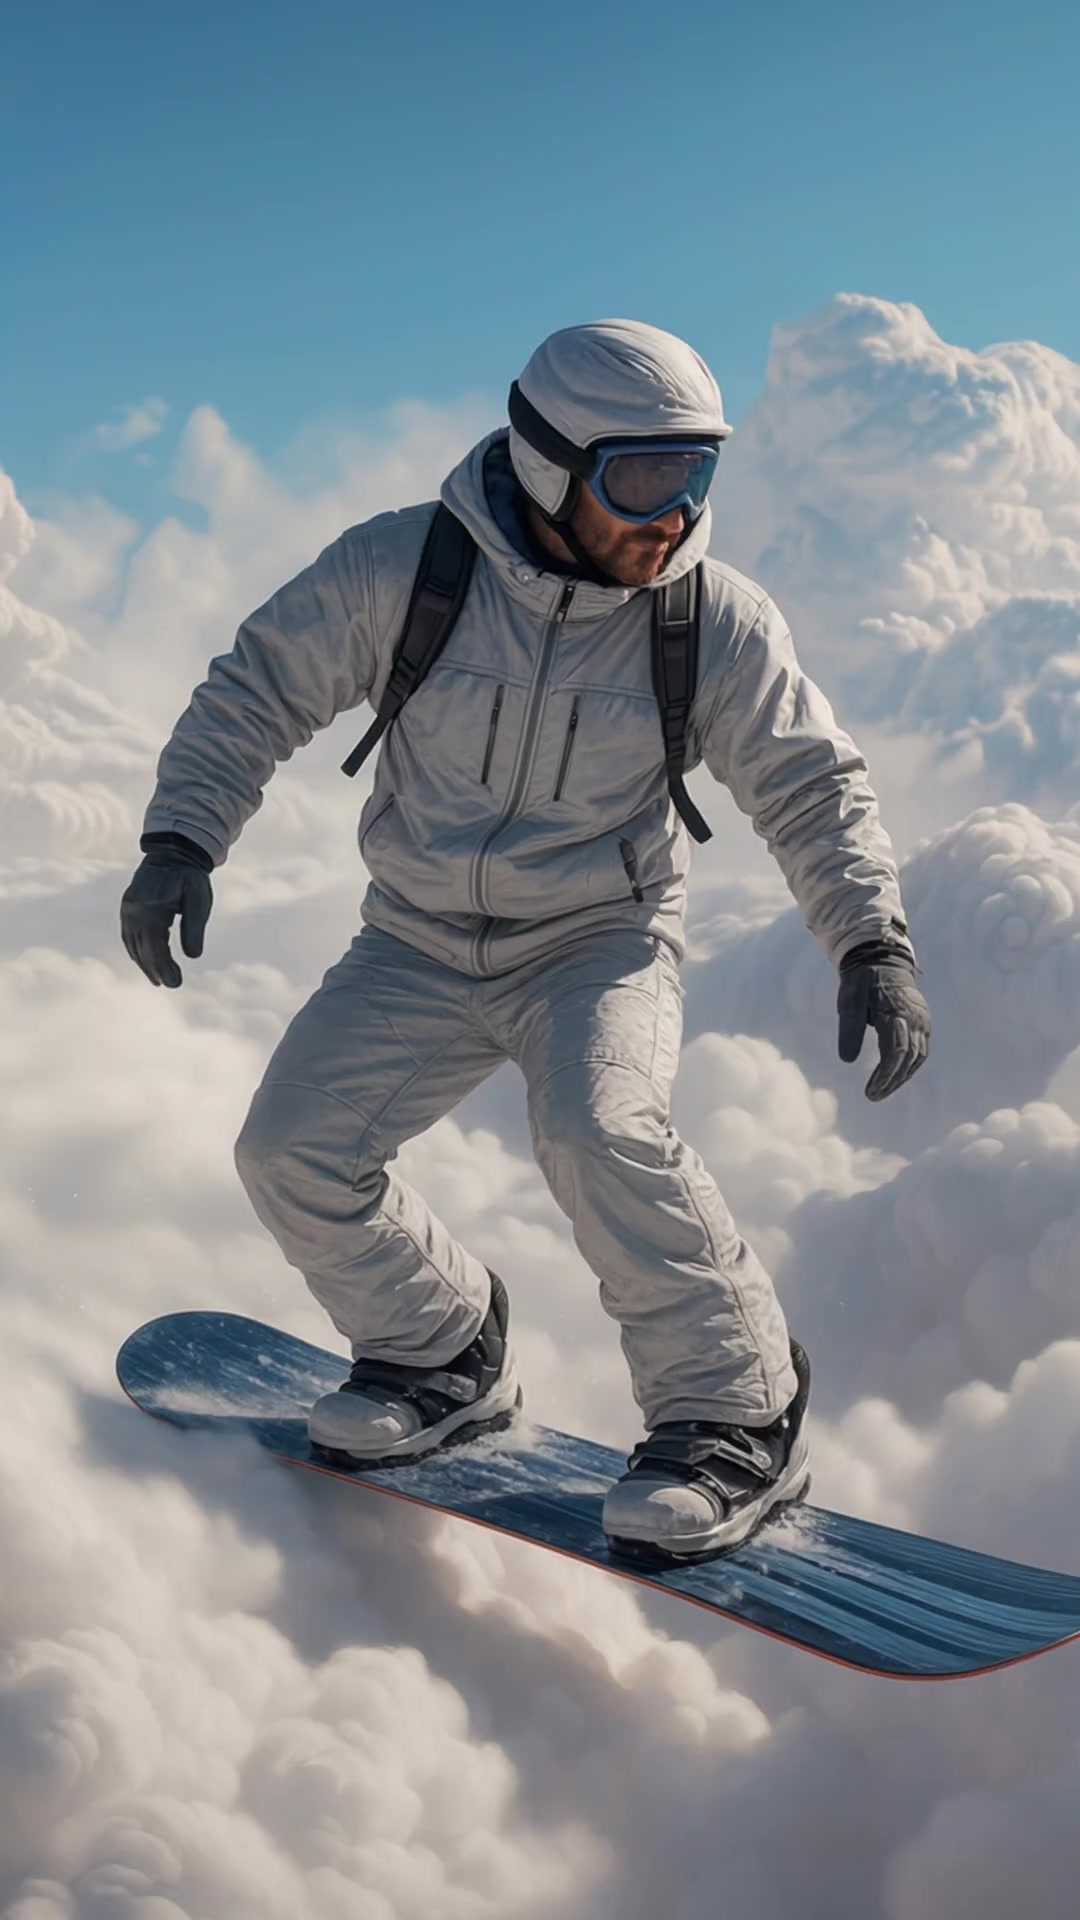
The snowboarder is riding across massive, fluffy white clouds as if they were snow-covered mountains, with dramatic lighting and deep shadows adding volume and realism. The background shows a stunning blue sky with scattered soft clouds and subtle light rays. crisp cinematic quality, vivid...
Используй это изображение как точный референс. Вертикальное реалистичное видео 9:16, тёплая кинематографичная ночная сцена в спальне. Полностью сохранить лица Ани и Павла, их внешность, причёски, одежду, освещение, кровать, панорамные окна и ночной город. Камера статичная, средний крупный план....
 Vídeo
Героя Валеру не меняем . Валера в ужасе бежит вниз по лестнице в подъезде сильно хромает на правую ногу и держится за перила . Останавливается на лестничной площадки и потирает рукой правое колено на лице мучительная боль . Бежит дальше по лестнице открывает дверь подъездную , спотыкается и...
 Vídeo
Первый кадр - взгляд от первого лица , моргание глаз и видно сначала мутно потом ясно. На белом фоне стоит спиной к нам в белом медицинском халате и шапочке тело с ярко аппетитными формами женского тела , ноги ниже халата ноги скелета в ярких ярких красных туфлях , двигает комично попой влево и...
 Vídeo
На белом фоне . 9:16 Перед глазами Валеры закрывается шторка голубого цвета . Камера отдаляется и показывает Валеру без штанов и без тапок в операционной: на операционном столе Валера и половину тела разделяет медицинская шторка голубого цвета , а около ног стоит скелет в Маске и медицинском...
 Vídeo
В расслабленном состоянии и довольные собой :Скелет ,сустав и доктор Ларин ( Доктор Ларин непрерывно двигает губами, как будто говорит, выразительные движения губ, оживление речи.) сидят за столом в комнате для отдыха и пьют чай Камера направляется на скелета , который делает глоток чая и...
 Vídeo
Локацию не меняем , плакаты и расположение вещей не меняем .Меняем время зелёного цвета на часах на”03: 19” .Сверху на часах лежит медицинская шапочка скелета. Валере приснился страшный сон. он ворочается и в ужасе просыпается , сердце бьется сильно ,течет пот, он часто дышит , понимает ,что это...
Camera: dolly in. Медленная кинематографичная панорама Гели и её питомцев-хранителей на залитой солнцем деревянной террасе. Легкий ветерок шелестит листвой в саду, в воздухе парят золотистые пылинки. пусть она будет в шортиках и футболке в розовых сандалях. А Рокси голосом мужским приятным ....
Camera: static. Оживи это изображение строго в 2D-анимационном стиле. Сохрани формат 9:16. Не меняй стиль картинки, цветовую гамму и уровень детализации. В кадре уже есть Василиса. Её не генерировать заново. Остальные персонажи — за кадром. Их не показывать, не добавлять, не рисовать. Порядок...
Slapstick Tom & Jerry style silent comedy, Pixar-quality 3D animation, 16:9, Malar Sunai — a glowing mountain pond surrounded by blue and purple Neelakurinji flowers under a twilight sky, jackfruit tree nearby. Komban the young elephant with TWO tusks, KANNUKUTTI the bipedal yellow calf on two...
Los controles se generan a partir del esquema del modelo. El código y el precio se actualizan al modificarlos.
/run/minimax/h3/flf2v/trainer?wait=20
presupuesto → 20,00 $
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/minimax/h3/flf2v/trainer?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "training_data_url": "https://example.com/your-file.zip"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/minimax/h3/flf2v/trainer?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"training_data_url": "https://example.com/your-file.zip"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"training_data_url": "https://example.com/your-file.zip",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/minimax/h3/flf2v/trainer", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "minimax/h3/flf2v/trainer",
"input": {
"training_data_url": "https://example.com/your-file.zip"
},
"wait_seconds": 20
}
}
}Tu clave permanece en este navegador: solo se envía a la Doitong API y solo se guarda en localStorage si marcas Recordar. Obtener una clave de API
Entrena un LoRA con un zip de clips de vídeo en `training_data_url` para que la generación pueda empezar con una imagen y terminar con otra. Las probabilidades de condicionamiento del primer, último y ambos fotogramas se establecen por separado. Los ajustes configurables incluyen `rank` (8 a 128), `number_of_steps` (1 a 15000), `learning_rate`, `number_of_frames` (22 a 124) y `aspect_ratio`. Devuelve los pesos LoRA y un archivo de configuración.
training_data_urlobligatorio
rankopcional
number_of_stepsopcional
learning_rateopcional
number_of_framesopcional
frame_rateopcional
resolutionopcional
aspect_ratioopcional
trigger_phraseopcional
first_frame_conditioning_popcional
auto_scale_inputopcional
split_input_into_scenesopcional
split_input_duration_thresholdopcional
debug_datasetopcional
strict_datasetopcional
last_frame_conditioning_popcional
first_last_frame_conditioning_popcional
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "minimax/h3/flf2v/trainer",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 20000,
    "usd": "20.00",
    "charged": 20000,
    "refunded": 0
  },
  "input": {
    "training_data_url": "https://example.com/your-file.zip"
  },
  "output": {
    "lora_file": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "config_file": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "debug_dataset": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    }
  },
  "outputs": [
    {
      "type": "file",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}Para agentes de IA: esta página en Markdown está en https://doitong.com/es-ES/developers/models/minimax/h3/flf2v/trainer.md. Todos los modelos y guías: https://doitong.com/developers/llms.txt