Imagen
GPT Image 2.5 Sunburst Text to Image Variantes: 4
≈ $0.054
54 créditos de API · ≈ ₽5.80
No hay coincidencias. Prueba con “video”, “FLUX” o “webhooks”.
Cargando modelos…
openai/gpt-image-2.5/flare/text-to-image
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
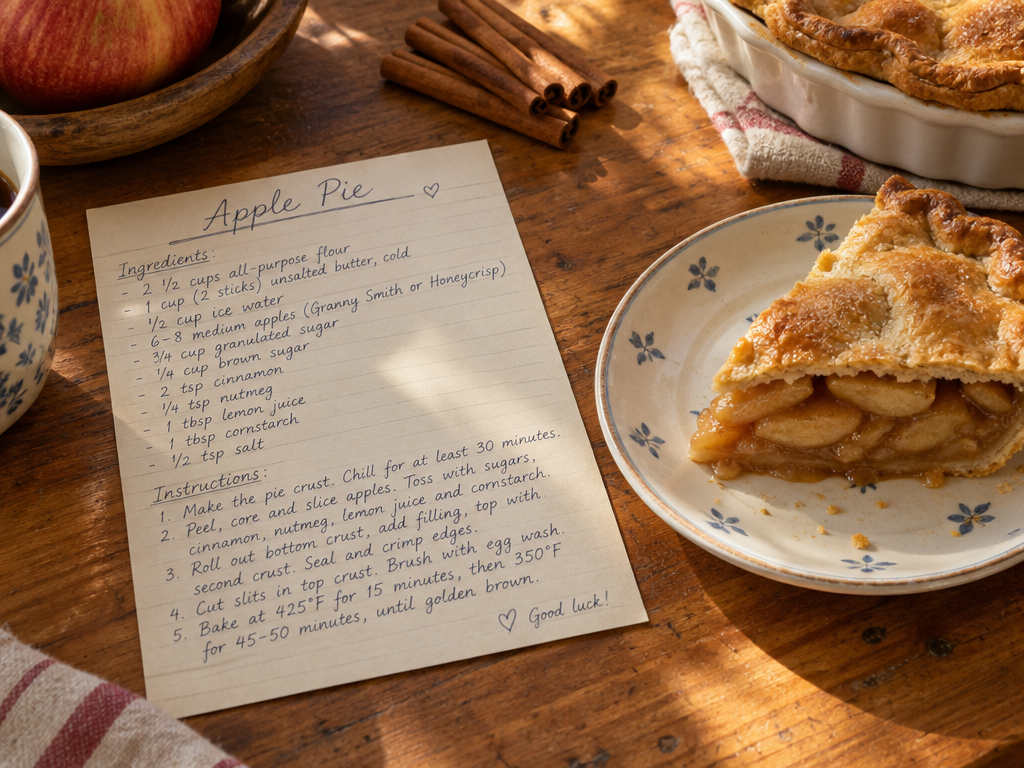
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/es-MX/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.ru/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
}Llama al modelo GPT Image 2.5 Text to Image (openai/gpt-image-2.5/flare/text-to-image) mediante Doitong API. Documentación para agentes: https://doitong.com/es-MX/developers/models/openai/gpt-image-2.5/flare/text-to-image.md
POST https://api.doitong.ru/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
Si el estado de la respuesta es "queued" o "running", consulta GET https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20 hasta que sea "succeeded"; los archivos están en outputs[].url. POST https://api.doitong.ru/v1/quote/openai/gpt-image-2.5/flare/text-to-image con el mismo cuerpo devuelve el precio exacto antes de la ejecución.Esta solicitud: $0.013 13 créditos de API · ≈ ₽1.40 Ejecutar en esta página
Tu nueva clave de API. Solo se muestra ahora y ya está en el código y en el campo de clave de API de abajo. Mantenla en secreto: nunca la incluyas en código que se ejecute en un navegador.
Los controles se generan a partir del esquema del modelo. El código y el precio se actualizan conforme los cambias.
/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
cotización → $0.013
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
},
"wait_seconds": 20
}
}
}Tu clave permanece en este navegador: solo se envía a la Doitong API y se guarda en localStorage únicamente si marcas Recordar. Obtener una clave de API
Trabajos públicos creados con GPT Image 2.5 por la comunidad de Doitong. Reutiliza un prompt con un clic.

Art style: Кинематографичный, реалистичный стиль. Она отнимает полотенце от лица. В зеркале — ее обычное, симпатичное лицо. Она смотрит с недоверием, затем на ее лице появляется огромное облегчение и легкая, искренняя улыбка. Свет снова становится теплым. ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━...
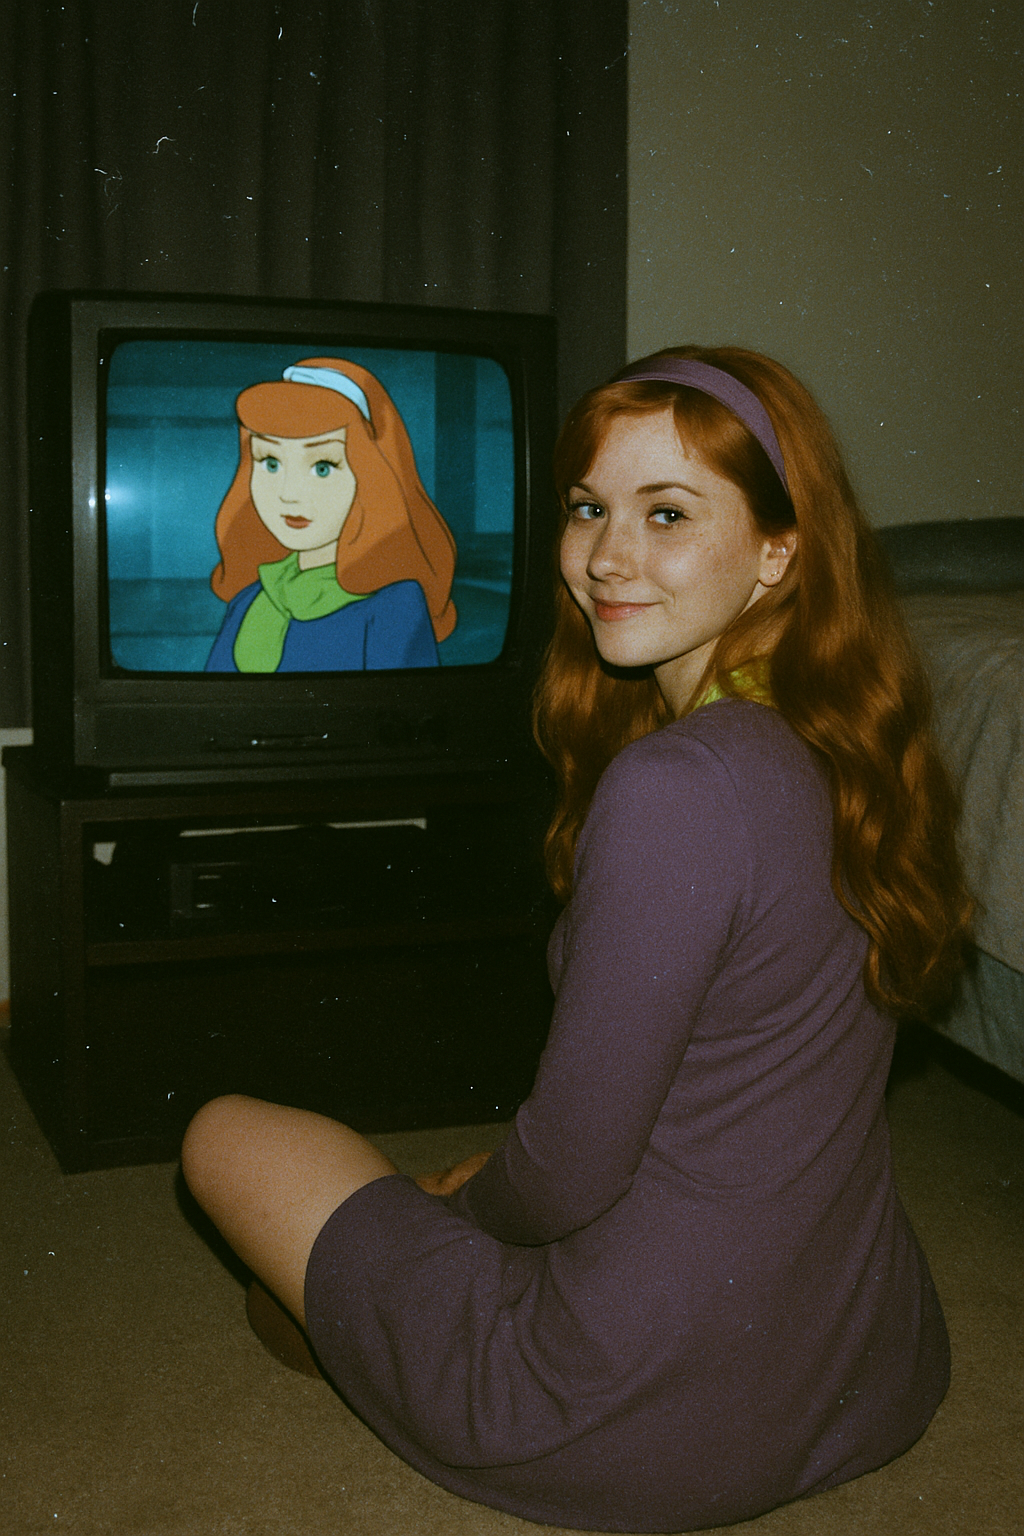
Grungy analog photo of Daphne Blake (from Serial scooby doo) watching her own movie on a 90s CRT TV in a dimly lit bedroom. The TV clearly shows animated scene from scooby doo, with a cartoon-style Daphne in her classic clothes on screen, smiling. Daphne Blake is sitting cross-legged on the floor...

Strong rule: style --- Cinematic Realistic ---. Энергичная девушка 27 лет с широкой лучезарной улыбкой и задорными искорками в темных глазах. Короткая стильная стрижка пикси, волосы выкрашены в модный пепельный блонд. Одета в яркую джинсовую куртку с цветными нашивками и белую футболку. Образ...

Strong rule: style --- Cinematic Realistic ---. Молодая женщина около 30 лет, утонченные черты лица, высокие скулы, пронзительные зеленые глаза. Волосы уложены в безупречное каре каштанового цвета. Одета в дорогой шелковый бежевый блейзер и изящные золотые украшения. Образ излучает уверенность,...

Use facial feature of attached photo. A realistic portrait of a woman with black hair loosely tied back, sitting outside a whitewashed stone house with a conical roof in a quiet Italian village. She wears a soft yellow floral summer dress with puff sleeves and white strappy heels. A wicker basket...

Фотореалистичная рекламная композиция в вертикальном формате 9:16. На переднем плане большая яркая глянцевая фольгированная розово-синяя упаковка чипсов в современном стильном дизайне, с глянцевой поверхностью, бликами и складками, как у реального продукта. В левом углу упаковки средний логотип...

Art style: Кинематографичный, реалистичный стиль. Резкая смена кадра. Девушка с ужасом смотрит на себя в зеркало. Маска снята, но ее лицо гротескно искажено: глаза слишком большие, улыбка растянута неестественно. Освещение стало холодным и резким. ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ FINAL...

Art style: Кинематографичный, реалистичный стиль. Резкая смена кадра. Девушка с ужасом смотрит на себя в зеркало. Маска снята, но ее лицо гротескно искажено: глаза слишком большие, улыбка растянута неестественно. Освещение стало холодным и резким. ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ FINAL...

Art style: Realistic Photography. Средний план. Самат сидит за минималистичным рабочим столом, смотрит прямо в камеру. На столе ноутбук и чашка кофе. Эстетика "Expert & Leader". ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ FINAL STYLE ENFORCEMENT (this is the authoritative rendering directive — it...
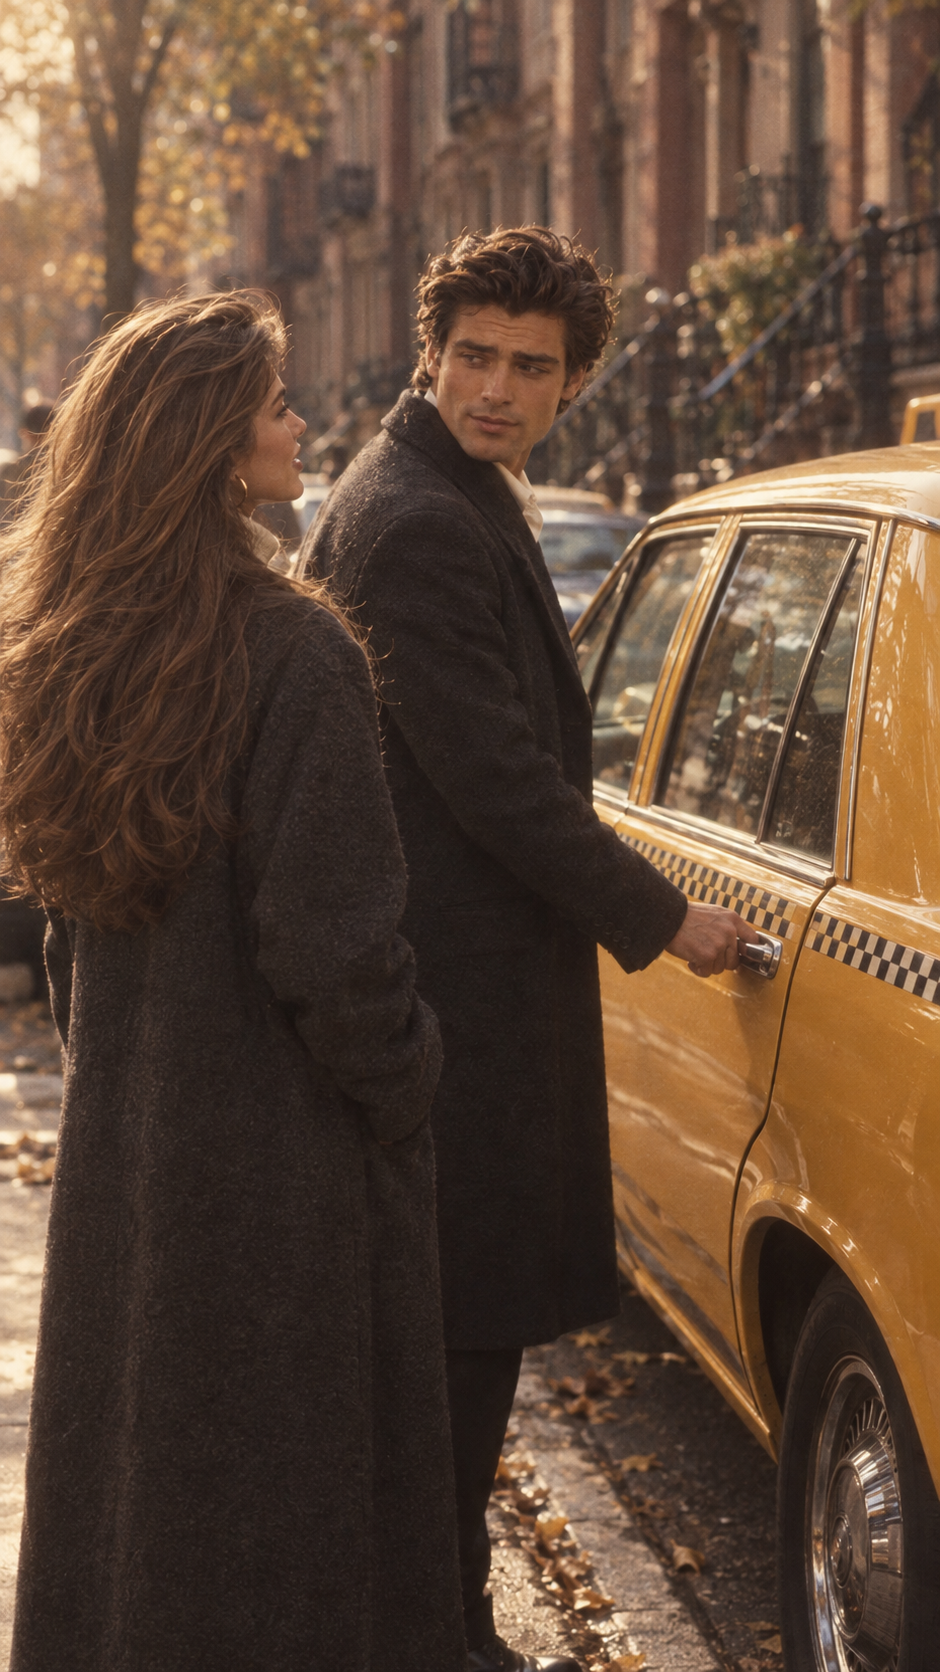
Art style: 90s Cinematic Fashion. Vertical 9:16 cinematic rear three-quarter exterior shot of a period-accurate four-door yellow New York taxi parked parallel and close to a Manhattan curb. The camera is positioned on the sidewalk slightly BEHIND the woman and man, looking diagonally toward the...

Use facial feature of attached photo. A realistic street style portrait of a smiling woman with shoulder-length black hair standing beside a small vintage white three-wheeled vehicle in a narrow old-town street. She wears a flowing pale yellow floral dress with a deep neckline and a front slit,...

Editorial business conference photography, a middle-aged man with short silver hair, warm olive skin, deep brown eyes, thick dark eyebrows, a neatly trimmed salt-and-pepper beard and mustache, strong jawline, calm confident expression, standing directly on the front edge of a massive keynote...

Use facial feature of attached photo. A realistic portrait of a woman with black hair loosely tied back, sitting outside a whitewashed stone house with a conical roof in a quiet Italian village. She wears a soft yellow floral summer dress with puff sleeves and white strappy heels. A wicker basket...

Art style: Кинематографичный, теплый и эмоциональный, в ст.... Солнечный осенний парк, дорожка усыпана желтыми листьями. Молодая мама и маленький мальчик идут рука об руку, улыбаясь друг другу. Свет мягкий и теплый, создавая уютную атмосферу. Стиль: теплая, кинематографичная фотография....

Art style: Кинематографичный, теплый и эмоциональный, в ст.... Мама и Мироша снова идут по дорожке парка. Теперь мама держит его на руках, и он с улыбкой смотрит по сторонам, показывая на что-то пальцем. На его лице больше нет слез. ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ FINAL STYLE ENFORCEMENT...

Art style: Кинематографичный, теплый и эмоциональный, в ст.... Крупный план: Мироша сидит на земле, его лицо искажено плачем, на глазах блестят слезы. Одна коленка испачкана землей. На заднем плане размытый силуэт подбегающей мамы. Композиция передает внезапность и расстройство....
Generador de imágenes de propósito general de OpenAI: sigue instrucciones largas y específicas, distribuye texto y diagramas con claridad y puede devolver PNG o WebP con fondo transparente para stickers, iconos y recortes de productos. Los cinco niveles de calidad equilibran velocidad y precio con el detalle. Los tamaños llegan hasta 3840 px en el borde más largo (múltiplos de 16, como máximo 3:1); hasta diez imágenes por solicitud.
Envía el nombre canónico o el nombre nativo, no ambos. Nombres canónicos
promptobligatorio
image_sizeopcional
backgroundopcional
qualityopcional
num_imagesopcional
num_outputs
output_formatopcional
output_compressionopcional
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "openai/gpt-image-2.5/flare/text-to-image",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 13,
    "usd": "0.013",
    "charged": 13,
    "refunded": 0
  },
  "input": {
    "prompt": "A flat vector sticker of a smiling cactus wearing sunglasses, thick white outline, no background",
    "image_size": "square_hd",
    "quality": "medium",
    "background": "transparent"
  },
  "output": {
    "images": [
      {
        "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
        "content_type": "image/jpeg",
        "file_name": "0-output.jpeg",
        "file_size": 1843200,
        "width": 1024,
        "height": 768
      }
    ]
  },
  "outputs": [
    {
      "type": "image",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}

Para agentes de IA: esta página en Markdown está disponible en https://doitong.com/es-MX/developers/models/openai/gpt-image-2.5/flare/text-to-image.md. Todos los modelos y guías: https://doitong.com/developers/llms.txt