Imagem
GPT Image 2.5 Sunburst Text to Image Variantes: 4
≈ $ 0,054
54 créditos de API · ≈ ₽ 5,80
Nenhum resultado. Tente “vídeo”, “FLUX” ou “webhooks”.
Carregando modelos…
openai/gpt-image-2.5/flare/text-to-image
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/pt-BR/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.ru/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
}Chame o modelo GPT Image 2.5 Text to Image (openai/gpt-image-2.5/flare/text-to-image) por meio da Doitong API. Documentação para agentes: https://doitong.com/pt-BR/developers/models/openai/gpt-image-2.5/flare/text-to-image.md
POST https://api.doitong.ru/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
Se o status da resposta for "queued" ou "running", consulte GET https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20 repetidamente até que seja "succeeded"; os arquivos estão em outputs[].url. POST https://api.doitong.ru/v1/quote/openai/gpt-image-2.5/flare/text-to-image com o mesmo corpo retorna o preço exato antes da execução.Esta solicitação: $ 0,013 13 créditos de API · ≈ ₽ 1,40 Executar nesta página
Sua nova chave de API. Ela é exibida apenas agora e já está no código e no campo de chave de API abaixo. Mantenha-a em segredo: nunca a coloque em um código executado no navegador.
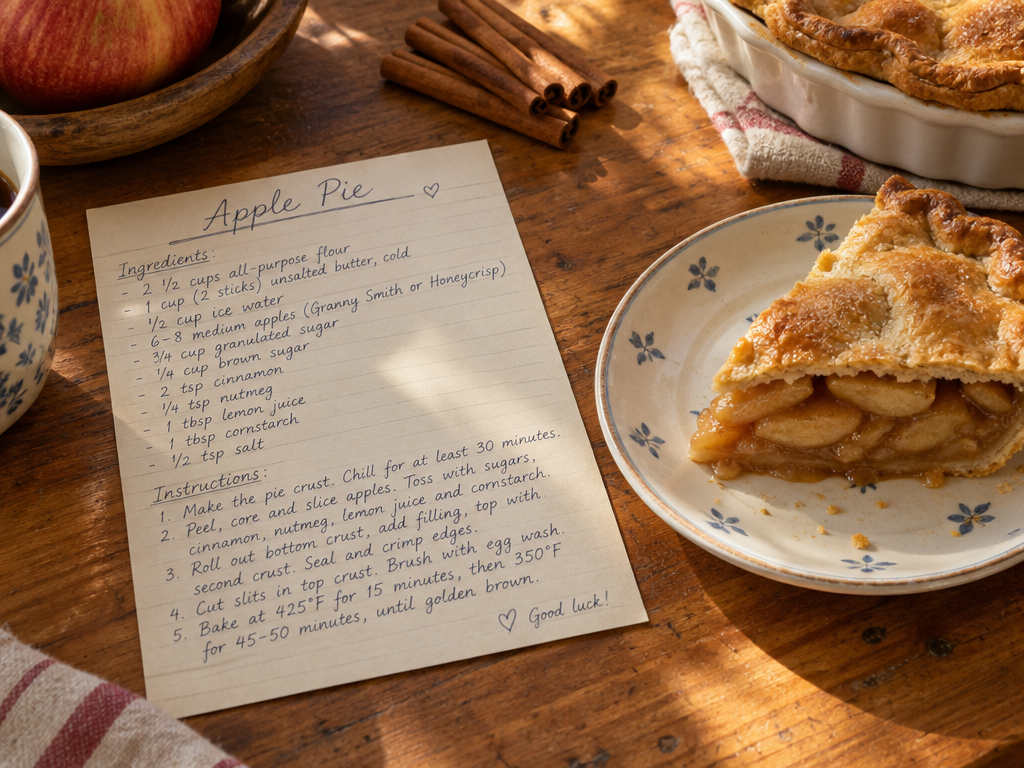
Os controles são gerados a partir do esquema do modelo. O código e o preço são atualizados conforme você os altera.
/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
cotação → $ 0,013
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
},
"wait_seconds": 20
}
}
}Sua chave permanece neste navegador: ela é enviada somente à Doitong API e salva (localStorage) apenas se você marcar Lembrar. Obter uma chave de API
Trabalhos públicos feitos com GPT Image 2.5 pela comunidade Doitong. Reutilize um prompt com um clique.

Art style: Кинематографичный, реалистичный стиль. Она отнимает полотенце от лица. В зеркале — ее обычное, симпатичное лицо. Она смотрит с недоверием, затем на ее лице появляется огромное облегчение и легкая, искренняя улыбка. Свет снова становится теплым. ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━...
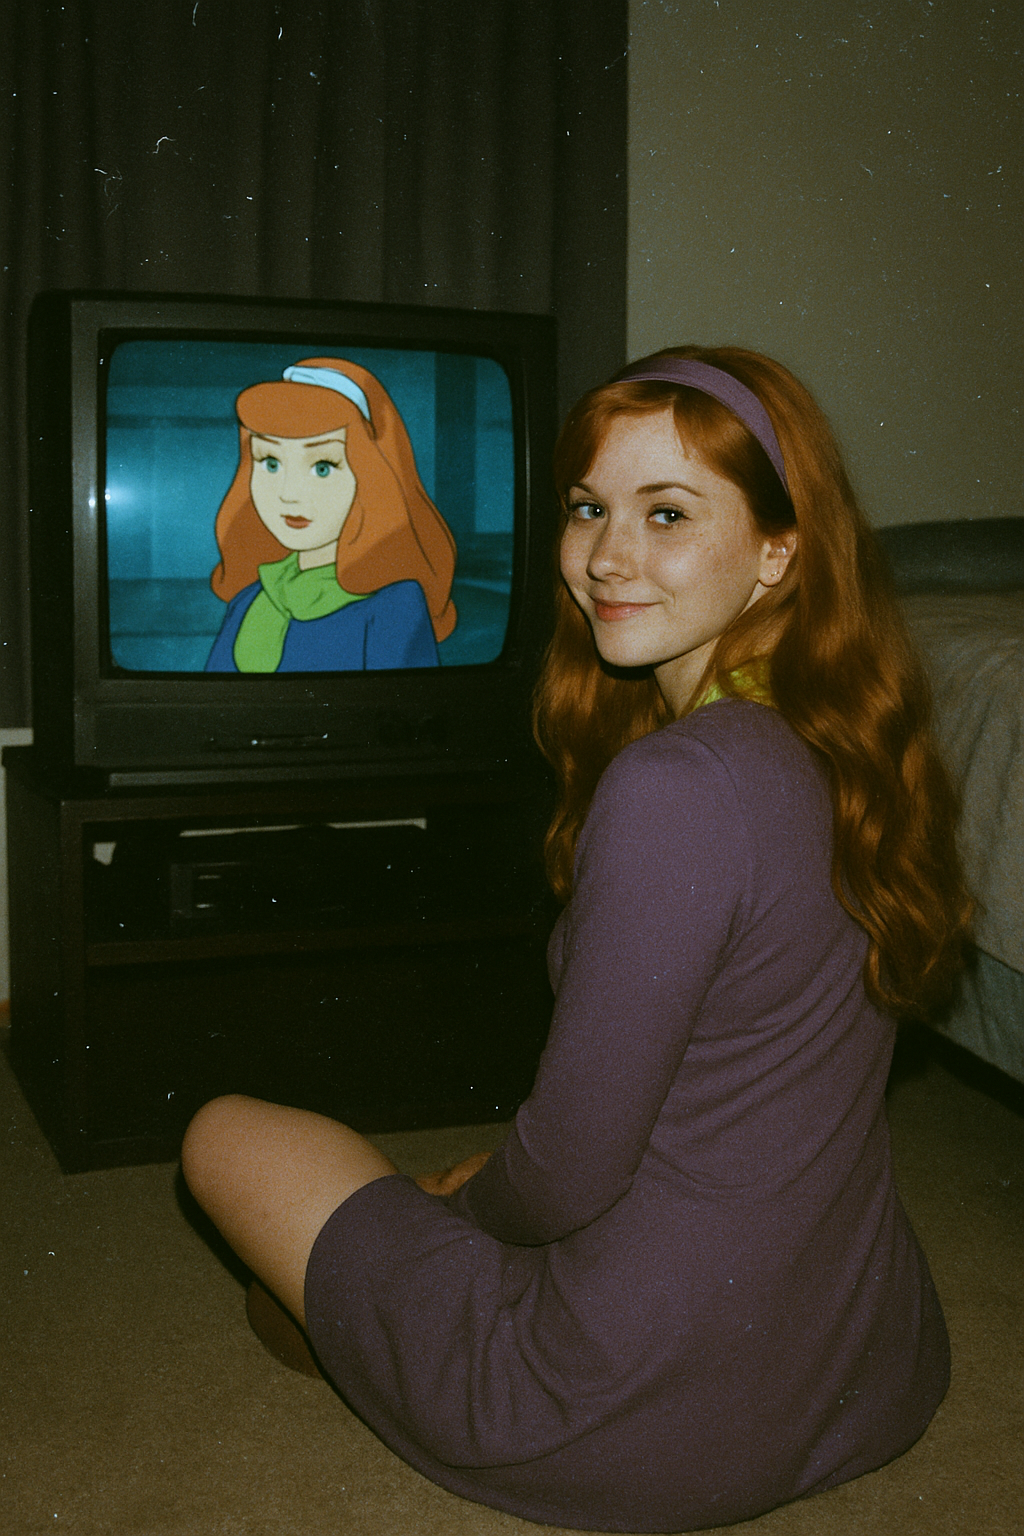
Grungy analog photo of Daphne Blake (from Serial scooby doo) watching her own movie on a 90s CRT TV in a dimly lit bedroom. The TV clearly shows animated scene from scooby doo, with a cartoon-style Daphne in her classic clothes on screen, smiling. Daphne Blake is sitting cross-legged on the floor...

Strong rule: style --- Cinematic Realistic ---. Энергичная девушка 27 лет с широкой лучезарной улыбкой и задорными искорками в темных глазах. Короткая стильная стрижка пикси, волосы выкрашены в модный пепельный блонд. Одета в яркую джинсовую куртку с цветными нашивками и белую футболку. Образ...

Strong rule: style --- Cinematic Realistic ---. Молодая женщина около 30 лет, утонченные черты лица, высокие скулы, пронзительные зеленые глаза. Волосы уложены в безупречное каре каштанового цвета. Одета в дорогой шелковый бежевый блейзер и изящные золотые украшения. Образ излучает уверенность,...

Use facial feature of attached photo. A realistic portrait of a woman with black hair loosely tied back, sitting outside a whitewashed stone house with a conical roof in a quiet Italian village. She wears a soft yellow floral summer dress with puff sleeves and white strappy heels. A wicker basket...

Фотореалистичная рекламная композиция в вертикальном формате 9:16. На переднем плане большая яркая глянцевая фольгированная розово-синяя упаковка чипсов в современном стильном дизайне, с глянцевой поверхностью, бликами и складками, как у реального продукта. В левом углу упаковки средний логотип...

Art style: Кинематографичный, реалистичный стиль. Резкая смена кадра. Девушка с ужасом смотрит на себя в зеркало. Маска снята, но ее лицо гротескно искажено: глаза слишком большие, улыбка растянута неестественно. Освещение стало холодным и резким. ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ FINAL...

Art style: Кинематографичный, реалистичный стиль. Резкая смена кадра. Девушка с ужасом смотрит на себя в зеркало. Маска снята, но ее лицо гротескно искажено: глаза слишком большие, улыбка растянута неестественно. Освещение стало холодным и резким. ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ FINAL...

Art style: Realistic Photography. Средний план. Самат сидит за минималистичным рабочим столом, смотрит прямо в камеру. На столе ноутбук и чашка кофе. Эстетика "Expert & Leader". ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ FINAL STYLE ENFORCEMENT (this is the authoritative rendering directive — it...
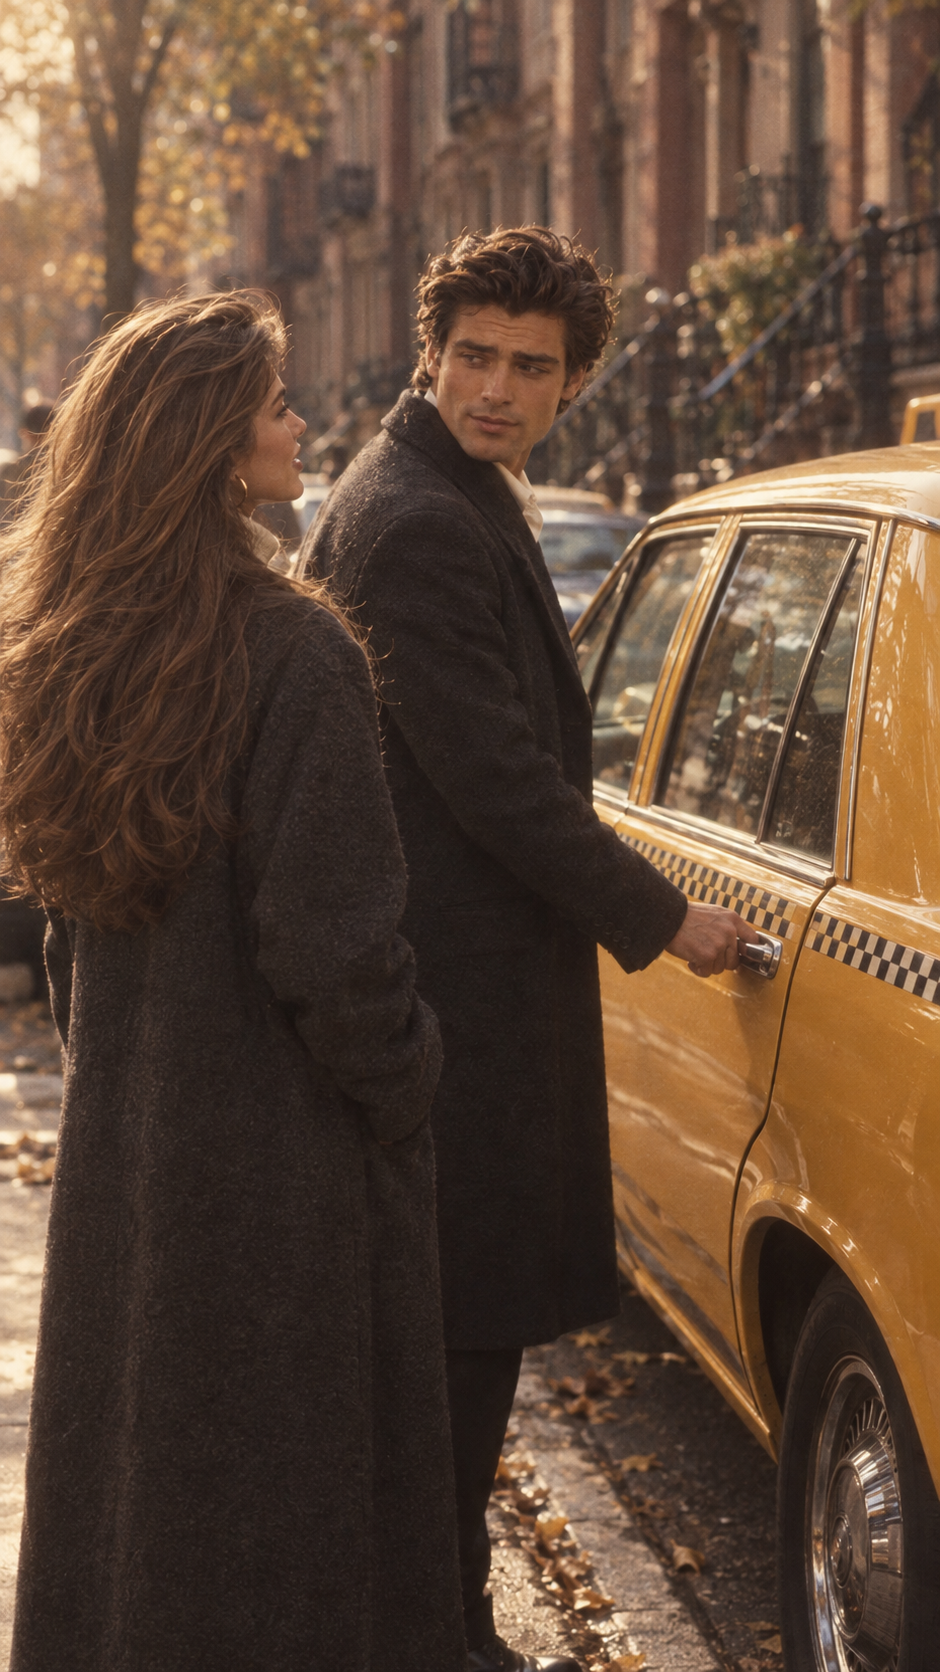
Art style: 90s Cinematic Fashion. Vertical 9:16 cinematic rear three-quarter exterior shot of a period-accurate four-door yellow New York taxi parked parallel and close to a Manhattan curb. The camera is positioned on the sidewalk slightly BEHIND the woman and man, looking diagonally toward the...

Use facial feature of attached photo. A realistic street style portrait of a smiling woman with shoulder-length black hair standing beside a small vintage white three-wheeled vehicle in a narrow old-town street. She wears a flowing pale yellow floral dress with a deep neckline and a front slit,...

Editorial business conference photography, a middle-aged man with short silver hair, warm olive skin, deep brown eyes, thick dark eyebrows, a neatly trimmed salt-and-pepper beard and mustache, strong jawline, calm confident expression, standing directly on the front edge of a massive keynote...

Use facial feature of attached photo. A realistic portrait of a woman with black hair loosely tied back, sitting outside a whitewashed stone house with a conical roof in a quiet Italian village. She wears a soft yellow floral summer dress with puff sleeves and white strappy heels. A wicker basket...

Art style: Кинематографичный, теплый и эмоциональный, в ст.... Солнечный осенний парк, дорожка усыпана желтыми листьями. Молодая мама и маленький мальчик идут рука об руку, улыбаясь друг другу. Свет мягкий и теплый, создавая уютную атмосферу. Стиль: теплая, кинематографичная фотография....

Art style: Кинематографичный, теплый и эмоциональный, в ст.... Мама и Мироша снова идут по дорожке парка. Теперь мама держит его на руках, и он с улыбкой смотрит по сторонам, показывая на что-то пальцем. На его лице больше нет слез. ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ FINAL STYLE ENFORCEMENT...

Art style: Кинематографичный, теплый и эмоциональный, в ст.... Крупный план: Мироша сидит на земле, его лицо искажено плачем, на глазах блестят слезы. Одна коленка испачкана землей. На заднем плане размытый силуэт подбегающей мамы. Композиция передает внезапность и расстройство....
Gerador de imagens de uso geral da OpenAI: segue instruções longas e específicas, organiza textos e diagramas com clareza e pode retornar PNG ou WebP com fundo transparente para adesivos, ícones e recortes de produtos. Cinco níveis de qualidade equilibram velocidade e preço com detalhamento. Os tamanhos chegam a 3840 px na borda mais longa (múltiplos de 16, no máximo 3:1); até dez imagens por solicitação.
Envie o nome canônico ou o nome nativo, não ambos. Nomes canônicos
promptobrigatório
image_sizeopcional
backgroundopcional
qualityopcional
num_imagesopcional
num_outputs
output_formatopcional
output_compressionopcional
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "openai/gpt-image-2.5/flare/text-to-image",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 13,
    "usd": "0.013",
    "charged": 13,
    "refunded": 0
  },
  "input": {
    "prompt": "A flat vector sticker of a smiling cactus wearing sunglasses, thick white outline, no background",
    "image_size": "square_hd",
    "quality": "medium",
    "background": "transparent"
  },
  "output": {
    "images": [
      {
        "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
        "content_type": "image/jpeg",
        "file_name": "0-output.jpeg",
        "file_size": 1843200,
        "width": 1024,
        "height": 768
      }
    ]
  },
  "outputs": [
    {
      "type": "image",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}

Para agentes de IA: esta página em Markdown está em https://doitong.com/pt-BR/developers/models/openai/gpt-image-2.5/flare/text-to-image.md. Todos os modelos e guias: https://doitong.com/developers/llms.txt