Vídeo
Wan-2.2 Text-to-Video A14B with LoRAs Variantes: 3
≈ desde 0,507 $
507 créditos de API · ≈ 54,54 ₽
No hay coincidencias. Prueba con “video”, “FLUX” o “webhooks”.
Cargando modelos…
wan/v2.2-a14b/text-to-image/lora
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan/v2.2-a14b/text-to-image/lora?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan/v2.2-a14b/text-to-image/lora", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/es/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.ru/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "wan/v2.2-a14b/text-to-image/lora",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
}Llama al modelo Wan v2.2 A14B Text-to-Image A14B with LoRAs (wan/v2.2-a14b/text-to-image/lora) mediante Doitong API. Documentación para agentes: https://doitong.com/es/developers/models/wan/v2.2-a14b/text-to-image/lora.md
POST https://api.doitong.ru/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
Si el estado de la respuesta es "queued" o "running", consulta GET https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20 hasta que sea "succeeded"; los archivos están en outputs[].url. POST https://api.doitong.ru/v1/quote/wan/v2.2-a14b/text-to-image/lora con el mismo cuerpo devuelve el precio exacto antes de la ejecución.Esta solicitud: 0,05 $ 50 créditos de API · ≈ 5,38 ₽ Ejecutar en esta página
Tu nueva clave de API. Solo se muestra ahora y ya está en el código y en el campo de clave de API de abajo. Mantenla en secreto: nunca la incluyas en código que se ejecute en un navegador.
Trabajos públicos creados con Wan v22 LoRA por la comunidad de Doitong. Reutiliza un prompt con un clic.
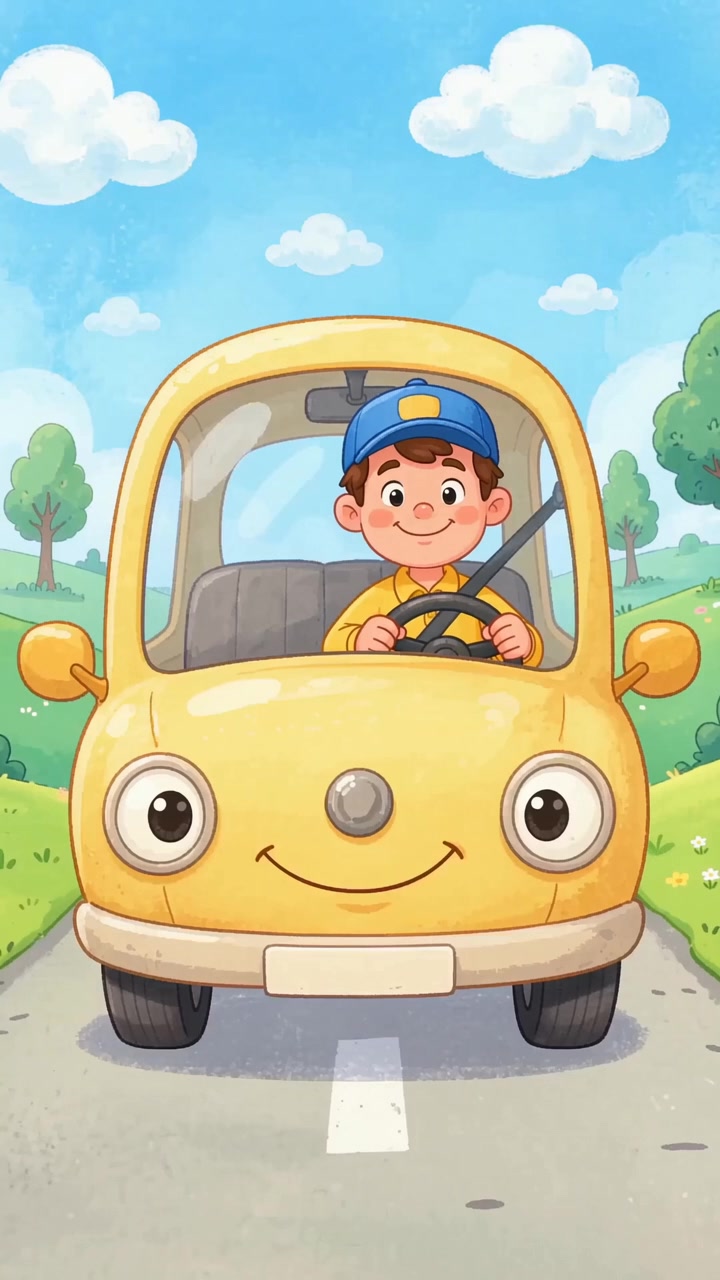 Vídeo
Создай 30-секундный обучающий музыкальный ролик для детей 3–5 лет. Тема: транспорт. Яркая 2D-анимация, весёлый водитель в кепке, крупные машины, пастельные цвета. 0:00–0:10 приветствие под музыку; 0:10–0:30 песенка: "Машина едет би-би, би-би", "Поезд едет ту-ту, ту-ту". Бодрая детская музыка...
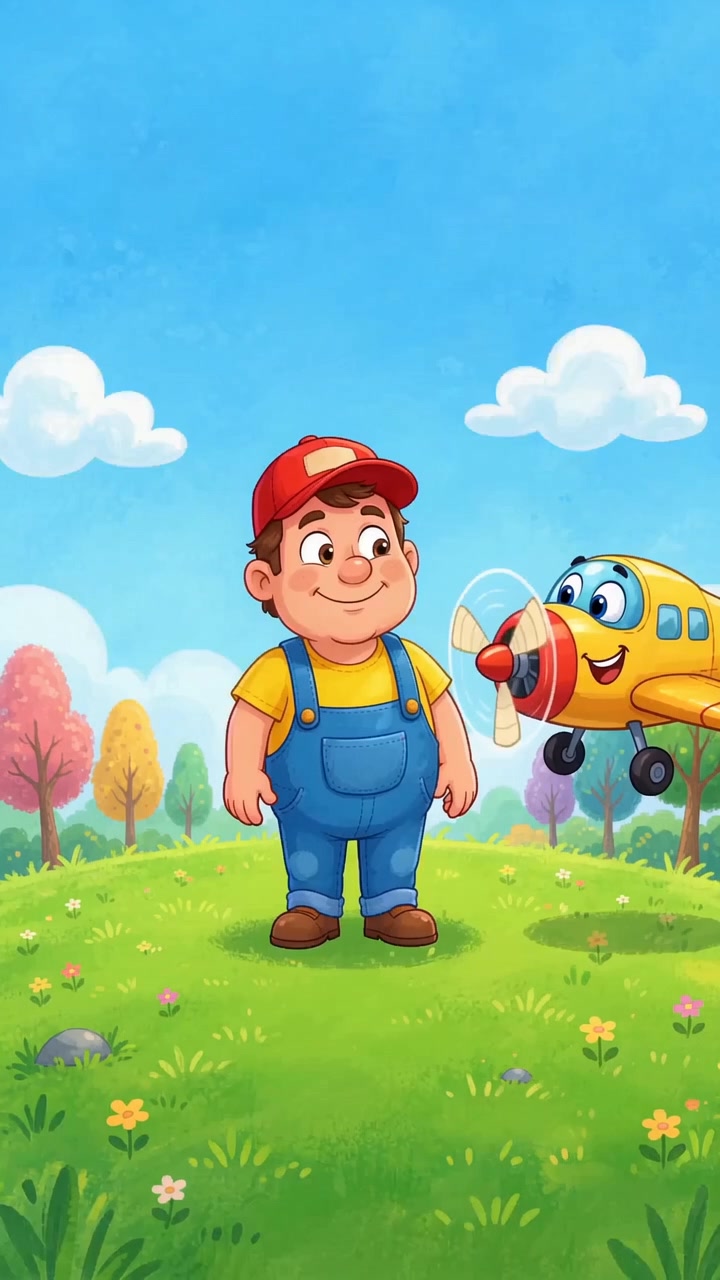 Vídeo
Создай 30-секундный обучающий музыкальный ролик для детей 3–5 лет. Тема: транспорт. Яркая 2D-анимация, тот же весёлый водитель в кепке, самолёт. 0:00–0:15 песенка: "Самолёт летит вж-ж-ж, вж-ж-ж"; 0:15–0:25 интерактивная пауза: водитель спрашивает "Как гудит машина?", пауза; 0:25–0:30 финальный...
Los controles se generan a partir del esquema del modelo. El código y el precio se actualizan al modificarlos.
/run/wan/v2.2-a14b/text-to-image/lora?wait=20
cotización → 0,05 $
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan/v2.2-a14b/text-to-image/lora?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan/v2.2-a14b/text-to-image/lora", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "wan/v2.2-a14b/text-to-image/lora",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
},
"wait_seconds": 20
}
}
}Tu clave permanece en este navegador: solo se envía a la Doitong API y se guarda (localStorage) únicamente si marcas Recordar. Obtener una clave de API
Genera una imagen a partir de un `prompt` y aplica pesos LoRA personalizados pasados en `loras`. `image_size` ofrece preajustes cuadrados, verticales y horizontales, e `image_format` puede ser png o jpeg. También incluye `guidance_scale`, `guidance_scale_2`, `num_inference_steps` hasta 40 y un `negative_prompt`.
promptobligatorio
negative_promptopcional
seedopcional
num_inference_stepsopcional
enable_safety_checkeropcional
enable_output_safety_checkeropcional
enable_prompt_expansionopcional
accelerationopcional
guidance_scaleopcional
guidance_scale_2opcional
shiftopcional
lorasopcional
loras[].pathobligatorio
loras[].weight_nameopcional
loras[].scaleopcional
loras[].transformeropcional
reverse_videoopcional
image_sizeopcional
image_formatopcional
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "wan/v2.2-a14b/text-to-image/lora",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 50,
    "usd": "0.05",
    "charged": 50,
    "refunded": 0
  },
  "input": {
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  },
  "output": {
    "image": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "seed": 42
  },
  "outputs": [
    {
      "type": "image",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}

Para agentes de IA: esta página en Markdown está en https://doitong.com/es/developers/models/wan/v2.2-a14b/text-to-image/lora.md. Todos los modelos y guías: https://doitong.com/developers/llms.txt