वीडियो
Wan-2.2 Text-to-Video A14B with LoRAs वेरिएंट: 3
≈ $0.507 से
507 API क्रेडिट · ≈ ₽54.41
कोई मिलान नहीं मिला। “video”, “FLUX” या “webhooks” आज़माएँ।
मॉडल लोड हो रहे हैं…
wan/v2.2-a14b/text-to-image/lora
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan/v2.2-a14b/text-to-image/lora?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan/v2.2-a14b/text-to-image/lora", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/hi/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.ru/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "wan/v2.2-a14b/text-to-image/lora",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
}Wan v2.2 A14B Text-to-Image A14B with LoRAs मॉडल (wan/v2.2-a14b/text-to-image/lora) को Doitong API के ज़रिए कॉल करें। एजेंट के लिए दस्तावेज़: https://doitong.com/hi/developers/models/wan/v2.2-a14b/text-to-image/lora.md
POST https://api.doitong.ru/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
यदि रिस्पॉन्स स्टेटस "queued" या "running" है, तो GET https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20 को तब तक पोल करें जब तक यह "succeeded" न हो जाए; फ़ाइलें outputs[].url में हैं। उसी बॉडी के साथ POST https://api.doitong.ru/v1/quote/wan/v2.2-a14b/text-to-image/lora चलाने से रन से पहले सटीक कीमत मिलती है।यह अनुरोध: $0.05 50 API क्रेडिट · ≈ ₽5.37 इसे इस पेज पर चलाएँ
आपकी नई API कुंजी। यह केवल अभी दिखाया गया है और कोड तथा नीचे दिए गए API कुंजी फ़ील्ड में पहले से मौजूद है। इसे गुप्त रखें: इसे कभी भी ब्राउज़र में चलने वाले कोड में न डालें।
Doitong समुदाय द्वारा Wan v22 LoRA से बनाए गए सार्वजनिक कार्य। एक क्लिक में प्रॉम्प्ट का पुनः उपयोग करें।
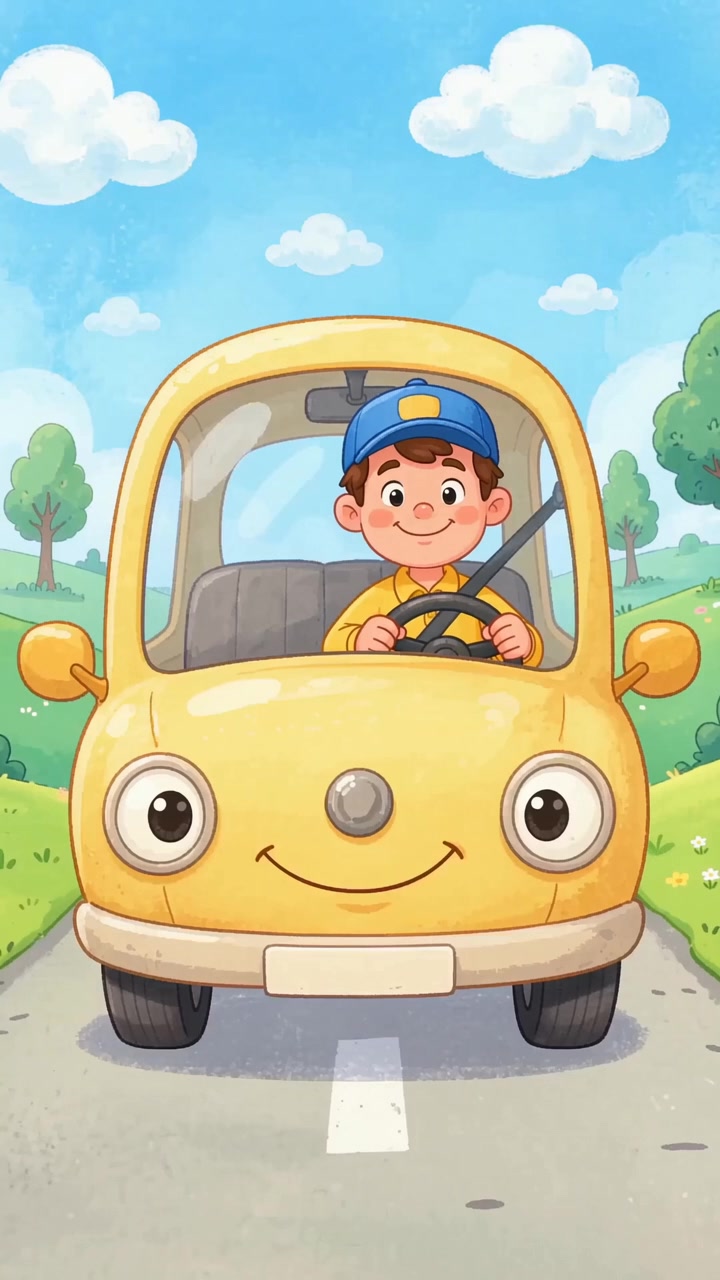 वीडियो
Создай 30-секундный обучающий музыкальный ролик для детей 3–5 лет. Тема: транспорт. Яркая 2D-анимация, весёлый водитель в кепке, крупные машины, пастельные цвета. 0:00–0:10 приветствие под музыку; 0:10–0:30 песенка: "Машина едет би-би, би-би", "Поезд едет ту-ту, ту-ту". Бодрая детская музыка...
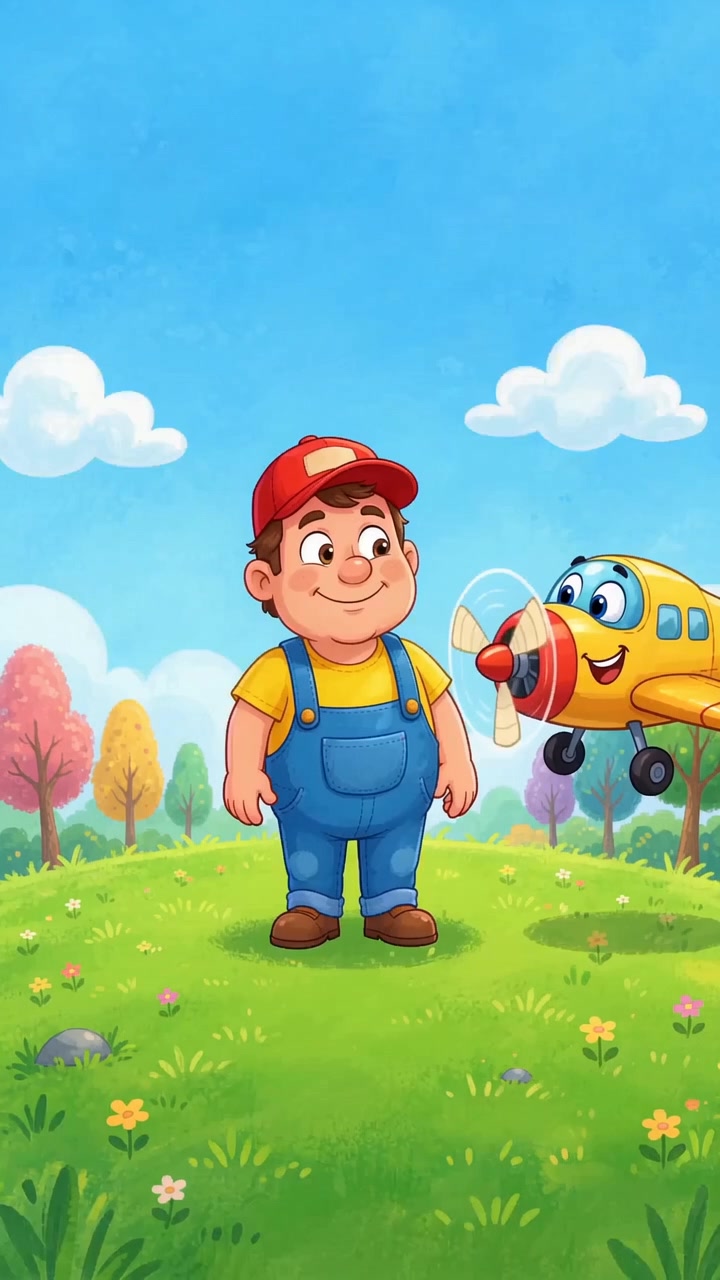 वीडियो
Создай 30-секундный обучающий музыкальный ролик для детей 3–5 лет. Тема: транспорт. Яркая 2D-анимация, тот же весёлый водитель в кепке, самолёт. 0:00–0:15 песенка: "Самолёт летит вж-ж-ж, вж-ж-ж"; 0:15–0:25 интерактивная пауза: водитель спрашивает "Как гудит машина?", пауза; 0:25–0:30 финальный...
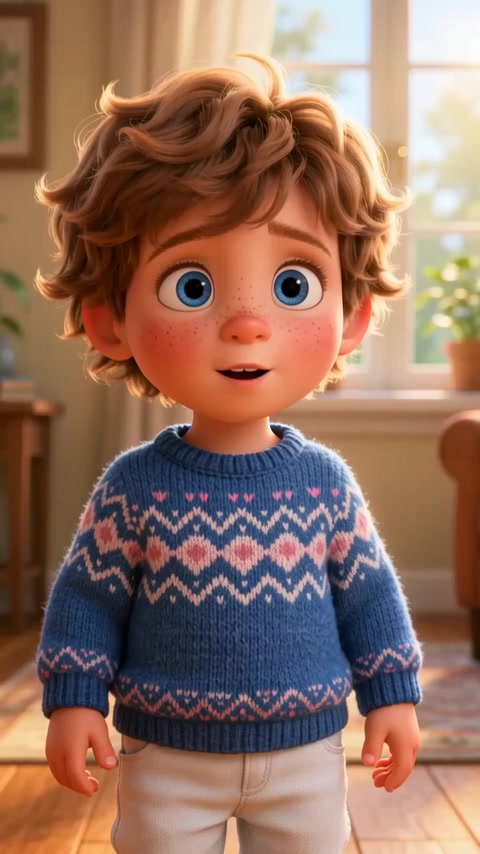 वीडियो
# PROMPT: Animated Mother’s Day greeting card **Format:** vertical video 9:16 **Duration:** 12–15 seconds **Style:** high‑quality Pixar‑inspired 3D animation, cinematic, warm, emotional, charming animated movie aesthetic. ### The main character is a child Use the attached image as the only and...
कंट्रोल मॉडल स्कीमा से जनरेट होते हैं। इन्हें बदलने पर कोड और कीमत अपडेट होती है।
/run/wan/v2.2-a14b/text-to-image/lora?wait=20
कोटेशन → $0.05
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan/v2.2-a14b/text-to-image/lora?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan/v2.2-a14b/text-to-image/lora", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "wan/v2.2-a14b/text-to-image/lora",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
},
"wait_seconds": 20
}
}
}आपकी key इसी ब्राउज़र में रहती है: इसे केवल Doitong API को भेजा जाता है और केवल तभी (localStorage) में सेव किया जाता है जब आप Remember चुनते हैं। API कुंजी प्राप्त करें
`prompt` से एक इमेज बनाता है और `loras` में दिए गए कस्टम LoRA वेट लागू करता है। `image_size` में वर्गाकार, पोर्ट्रेट और लैंडस्केप प्रीसेट उपलब्ध हैं, और `image_format` png या jpeg होता है। इसमें `guidance_scale`, `guidance_scale_2`, 40 तक `num_inference_steps` और `negative_prompt` भी हैं।
promptआवश्यक
negative_promptवैकल्पिक
seedवैकल्पिक
num_inference_stepsवैकल्पिक
enable_safety_checkerवैकल्पिक
enable_output_safety_checkerवैकल्पिक
enable_prompt_expansionवैकल्पिक
accelerationवैकल्पिक
guidance_scaleवैकल्पिक
guidance_scale_2वैकल्पिक
shiftवैकल्पिक
lorasवैकल्पिक
loras[].pathआवश्यक
loras[].weight_nameवैकल्पिक
loras[].scaleवैकल्पिक
loras[].transformerवैकल्पिक
reverse_videoवैकल्पिक
image_sizeवैकल्पिक
image_formatवैकल्पिक
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "wan/v2.2-a14b/text-to-image/lora",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 50,
    "usd": "0.05",
    "charged": 50,
    "refunded": 0
  },
  "input": {
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  },
  "output": {
    "image": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "seed": 42
  },
  "outputs": [
    {
      "type": "image",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}

AI एजेंट के लिए: इस पेज का Markdown यहाँ है https://doitong.com/hi/developers/models/wan/v2.2-a14b/text-to-image/lora.md. सभी मॉडल और गाइड: https://doitong.com/developers/llms.txt