동영상
Wan-2.2 Text-to-Video A14B with LoRAs 변형: 3개
≈ $0.507부터
507 API 크레딧 · ≈ ₽54.54
일치하는 항목이 없습니다. “video”, “FLUX” 또는 “webhooks”를 검색해 보세요.
모델 로드 중…
wan/v2.2-a14b/text-to-image/lora
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan/v2.2-a14b/text-to-image/lora?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan/v2.2-a14b/text-to-image/lora", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/ko/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.ru/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "wan/v2.2-a14b/text-to-image/lora",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
}Doitong API를 통해 Wan v2.2 A14B Text-to-Image A14B with LoRAs 모델(wan/v2.2-a14b/text-to-image/lora)을 호출합니다. 에이전트용 문서: https://doitong.com/ko/developers/models/wan/v2.2-a14b/text-to-image/lora.md
POST https://api.doitong.ru/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
응답 상태가 "queued" 또는 "running"이면 "succeeded"가 될 때까지 GET https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20을 폴링하세요. 파일은 outputs[].url에 있습니다. POST https://api.doitong.ru/v1/quote/wan/v2.2-a14b/text-to-image/lora에 동일한 본문을 보내면 실행 전에 정확한 가격을 반환합니다.이 요청: $0.05 50 API 크레딧 · ≈ ₽5.38 이 페이지에서 실행
새 API 키입니다. 지금만 표시되며 이미 아래 코드와 API 키 필드에 입력되어 있습니다. 안전하게 보관하세요. 브라우저에서 실행되는 코드에 절대 넣지 마세요.
Doitong 커뮤니티가 Wan v22 LoRA로 만든 공개 작품입니다. 한 번의 클릭으로 프롬프트를 재사용하세요.
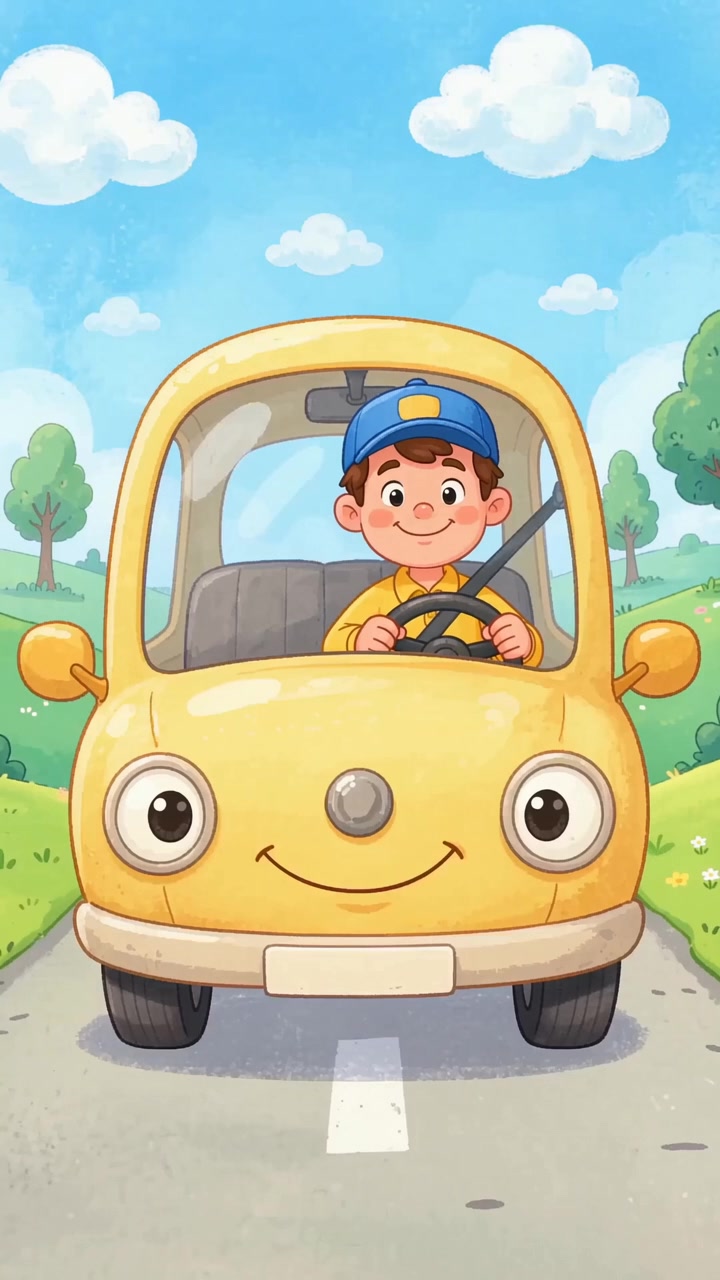 동영상
Создай 30-секундный обучающий музыкальный ролик для детей 3–5 лет. Тема: транспорт. Яркая 2D-анимация, весёлый водитель в кепке, крупные машины, пастельные цвета. 0:00–0:10 приветствие под музыку; 0:10–0:30 песенка: "Машина едет би-би, би-би", "Поезд едет ту-ту, ту-ту". Бодрая детская музыка...
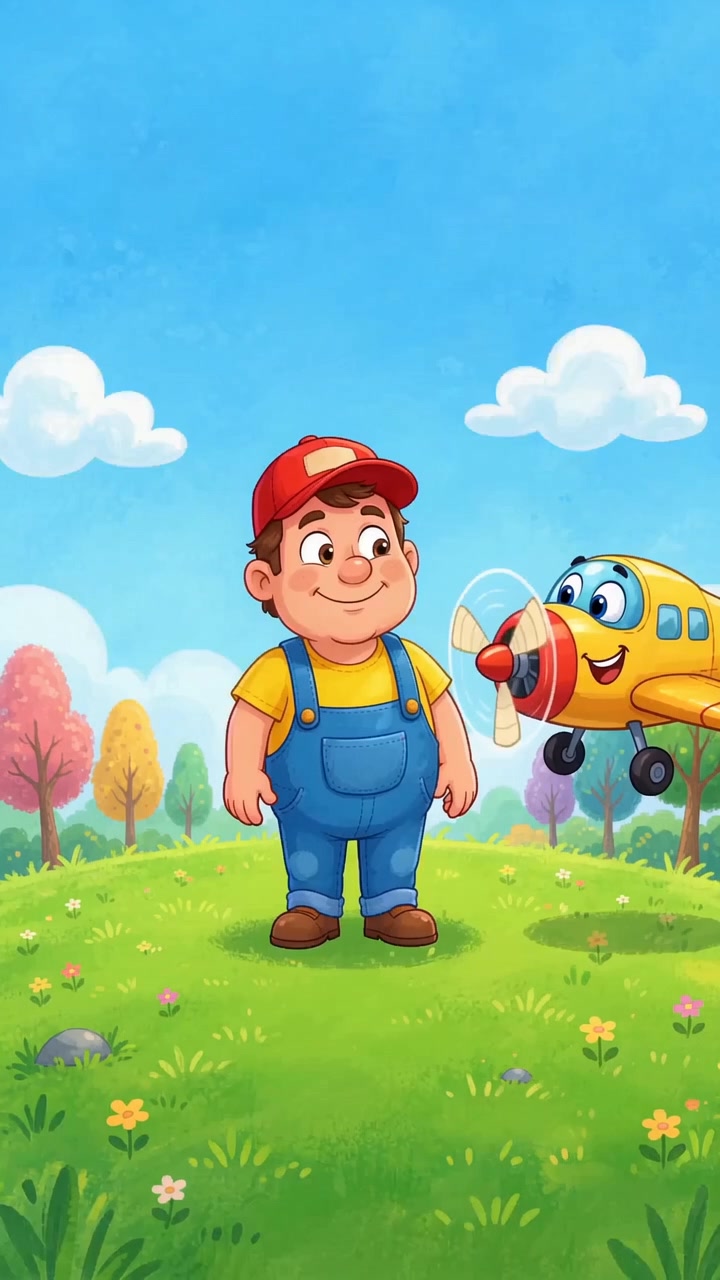 동영상
Создай 30-секундный обучающий музыкальный ролик для детей 3–5 лет. Тема: транспорт. Яркая 2D-анимация, тот же весёлый водитель в кепке, самолёт. 0:00–0:15 песенка: "Самолёт летит вж-ж-ж, вж-ж-ж"; 0:15–0:25 интерактивная пауза: водитель спрашивает "Как гудит машина?", пауза; 0:25–0:30 финальный...
컨트롤은 모델 스키마에서 생성됩니다. 값을 변경하면 코드와 가격이 업데이트됩니다.
/run/wan/v2.2-a14b/text-to-image/lora?wait=20
견적 → $0.05
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan/v2.2-a14b/text-to-image/lora?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan/v2.2-a14b/text-to-image/lora", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "wan/v2.2-a14b/text-to-image/lora",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
},
"wait_seconds": 20
}
}
}`prompt`에서 이미지를 생성하고 `loras`로 전달된 사용자 지정 LoRA 가중치를 적용합니다. `image_size`는 정사각형, 세로 및 가로 사전 설정을 제공하며 `image_format`은 png 또는 jpeg입니다. `guidance_scale`, `guidance_scale_2`, 최대 40의 `num_inference_steps` 및 `negative_prompt`도 지원합니다.
prompt필수
negative_prompt선택 사항
seed선택 사항
num_inference_steps선택 사항
enable_safety_checker선택 사항
enable_output_safety_checker선택 사항
enable_prompt_expansion선택 사항
acceleration선택 사항
guidance_scale선택 사항
guidance_scale_2선택 사항
shift선택 사항
loras선택 사항
loras[].path필수
loras[].weight_name선택 사항
loras[].scale선택 사항
loras[].transformer선택 사항
reverse_video선택 사항
image_size선택 사항
image_format선택 사항
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "wan/v2.2-a14b/text-to-image/lora",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 50,
    "usd": "0.05",
    "charged": 50,
    "refunded": 0
  },
  "input": {
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  },
  "output": {
    "image": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "seed": 42
  },
  "outputs": [
    {
      "type": "image",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}

AI 에이전트용: 이 페이지의 Markdown 버전: https://doitong.com/ko/developers/models/wan/v2.2-a14b/text-to-image/lora.md. 모든 모델 및 가이드: https://doitong.com/developers/llms.txt